Anthropic 보고서로 본 LLM의 실제 공격 활용 — GTG-10007을 중심으로
Anthropic의 2026년 9월 보고서를 바탕으로 GTG-10007의 병렬 작업과 이전 기록 활용 방식을 살펴보고, LLM이 맡은 작업과 보고된 피해를 구분한다.
목차 8
LLM을 활용한 취약점 진단의 참고 자료
LLM을 이용한 침투테스트를 진행했고, 이어서 오픈소스를 대상으로 취약점 진단을 진행하고 있다. 이 과정에서 LLM에 어떤 일을 맡길 수 있고, 사람이 어디에서 판단해야 하는지 참고할 만한 자료가 필요했다. 실제 진단, 공격 사례에서는 LLM을 어떤 방식으로 활용하는지 살펴보고 싶었다.
마침 2026년 9월 10일 Anthropic이 「Detecting and countering misuse of AI: September 2026」을 공개했다. Claude가 실제 악성 활동에 어떻게 쓰였는지를 정리한 위협 인텔리전스 보고서다.1 보안 진단을 위한 안내서는 아니지만, 실제 공격자가 LLM에 맡긴 작업과 사람이 개입한 지점을 함께 볼 수 있는 자료다.
이 글에서는 그중 LLM이 공격 과정에서 어떤 일을 맡았는가를 살펴본다. 코드 작성을 돕는 수준부터 여러 작업의 진행을 에이전트에 맡기는 경우까지, 활용 범위가 어떻게 달랐는지 보려 한다. 특히 작업을 병렬로 진행하고 이전 기록을 다음 작업에 활용한 GTG-10007에 초점을 맞췄다. GTG는 Anthropic이 AI를 악용한 개인이나 집단을 추적할 때 사용하는 내부 식별자다.2
같은 Claude 활용도 맡긴 범위는 달랐다
보고서의 사이버 공격 사례 중 비교할 만한 내용을 추리면 다음과 같다.2
| 사례 | 이 글에서 비교할 대표 작업 |
|---|---|
| GTG-20006 | 사람이 공격 대상을 정하는 시스템 침입과 일부 예약 작업의 자동 실행 |
| GTG-50014 | 에이전트를 이용한 여러 피해 조직의 시스템 침입과 데이터 탈취 |
| GTG-10007 | 병렬 취약점 연구, 세션 간 기록 유지, 예약된 공개자료 수집 |
같은 공격에서도 작업에 따라 사람의 개입 정도는 달랐다. 표는 각 사례의 대표 작업을 비교한 것으로, 공격 전체가 얼마나 자율적으로 진행됐는지 등급을 매긴 것은 아니다.3
이들을 모두 ‘AI 해킹’으로 묶으면 중요한 차이가 사라진다. 코드를 작성한 주체, 실행을 결정한 주체, 다음 작업을 선택한 주체가 같지 않을 수 있기 때문이다.
에이전트의 역할을 이해할 때는 모델 이름보다 어떤 일을 맡겼는지 보는 편이 보통 도움이 된다. 사람이 분석 결과를 읽고 다음 지시를 내리는지, 시스템이 그 결과를 받아 다른 작업까지 이어가는지를 확인하는 것이다.
GTG-10007에서는 여러 작업과 이전 기록이 연결됐다
GTG-10007에서는 보안 제품의 구성요소별 취약점 연구, 정부기관 네트워크 정찰, 예약된 공개자료 수집 등 서로 다른 작업이 병행됐다. 에듀테크 기업의 학생 정보 유출과 소매업체의 운영 시스템 접근도 Anthropic이 보고한 피해에 포함된다.4
Anthropic의 설명에 따르면, 총괄 에이전트가 정찰과 침입 후 작업을 나눠 여러 하위 에이전트에 병렬로 맡겼다. 대상 목록, 탈취한 자격증명, 진행 상태와 계속 적용할 지시는 세션이 끝나도 저장해 뒀다. 다음 세션에서는 이 기록을 불러와 중단한 지점부터 작업을 이어갈 수 있었다.4
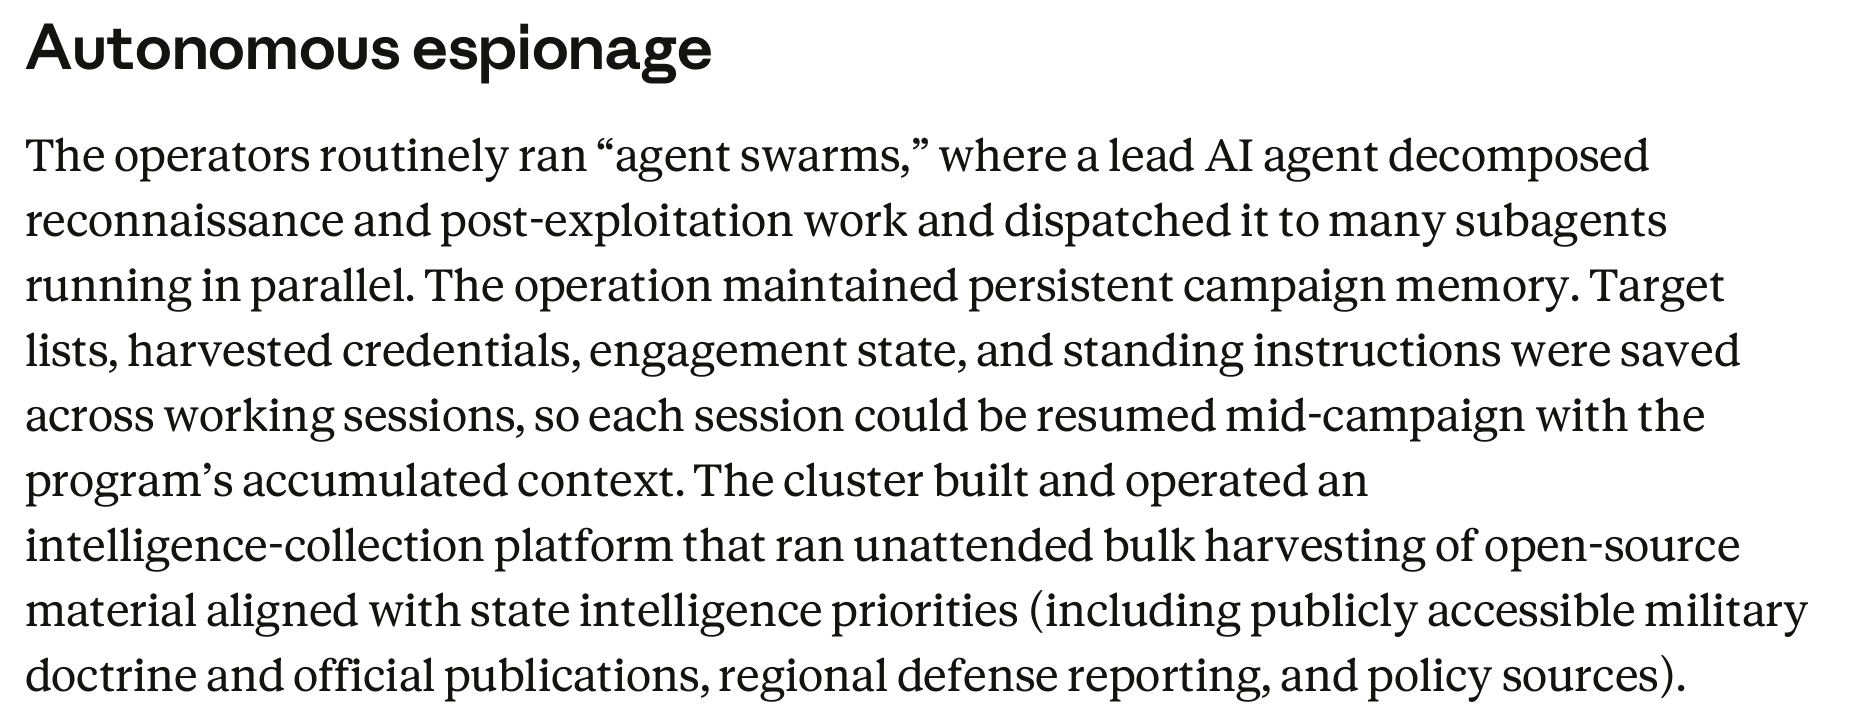
출처: Anthropic 보고서, 26쪽.
취약점 연구에서는 프로젝트에 저장한 기록을 구성요소별 분석에 활용했고, 정찰에서도 앞서 조사한 결과를 다음 작업에서 참고했다. 별도로 운영된 공개자료 수집 플랫폼은 공개된 군사·정부 간행물과 정책 자료 등을 정해진 일정에 따라 수집했다. 이 수집 작업은 앞서 언급한 학생 개인정보 유출과 대상·성격이 다르다.4
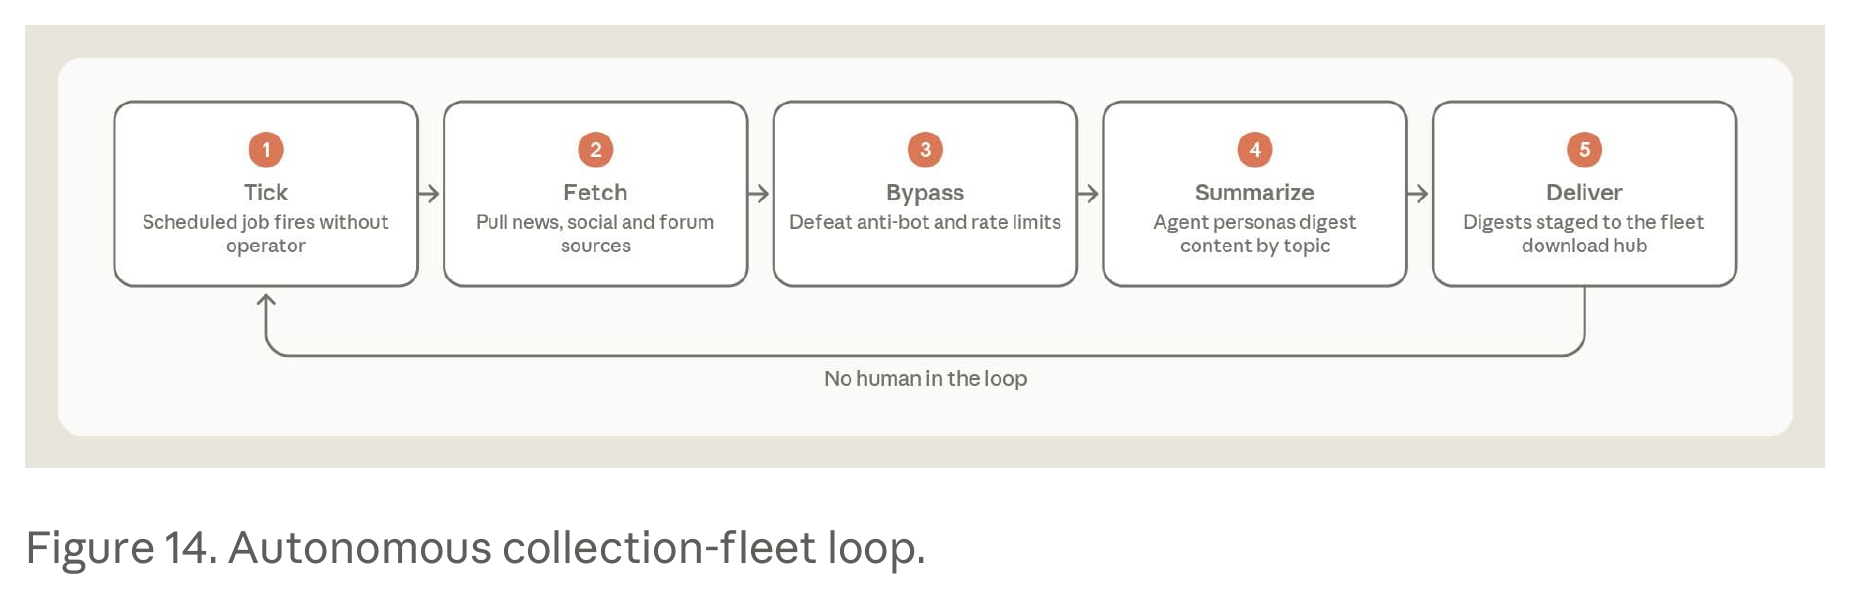
출처: Anthropic 보고서, 28쪽 Figure 14.
병렬 작업을 해석할 때 내가 보는 기준은 동시에 실행되는 에이전트의 수보다 서로 다른 질문을 나눠 맡았는가다. 같은 입력으로 비슷한 답을 여러 번 받았다면 작업 수는 늘어도 조사 범위가 넓어졌다고 보기 어렵다. 반대로 조사할 부분을 나누고 결과를 모을 수 있다면, 사람이 작업 사이를 오가는 부담을 줄일 여지가 있다. 다만 어느 정도 줄었는지는 별도의 측정이 필요하다.
저장한 기록을 다시 쓸 때는 정확성도 살펴야 한다. 이전 결과를 다음 작업에 활용할 때, 확인된 사실과 아직 검토하지 않은 추정이 구분되는가? 잘못된 가정이 저장되면 이후 작업도 그 가정에서 출발할 수 있다. 기록을 오래 보관하는 것과 그 내용을 정확하게 활용하는 것은 별도로 평가해야 한다.
예약된 공개자료 수집에서도 프로그램을 만드는 데 Claude를 쓴 것과, 실행 중인 Claude가 결과를 해석해 다음 작업을 선택한 것은 구분할 필요가 있다. 예약 실행이 있었다는 사실만으로 매번 LLM이 판단했거나 표적 선정과 결과 판단까지 모두 자동화됐다고 결론 내릴 수는 없다.
취약점 후보 수와 보고된 피해는 다른 숫자다
보고서에는 한 달 동안 제로데이로 의심되는 취약점 후보를 12건 넘게 찾아낸 사례가 나온다. 공격자가 자체 테스트 환경에서 검증했다는 설명도 있다.4
여기서 후보 수를 확정된 취약점 수나 CVE 수로 바꿔 적으면 의미가 달라진다. 의심스러운 동작을 찾은 것, 특정 조건에서 확인한 것, 실제 제품의 영향을 입증한 것, 외부 검토를 거친 것은 각각 다른 단계다.
지난 프로젝트를 진행하면서 이런 숫자를 읽을 때 ‘몇 건인가’보다 먼저 무엇을 한 건으로 세었는가를 확인하는 게 중요하다는 걸 깨달았다. 분석 결과 파일 하나인지, 서로 다른 원인의 취약점인지, 제품 개발자가 받아들인 보고서인지에 따라 같은 숫자도 전혀 다른 성과를 뜻한다.
표적 수와 피해 조직 수도 마찬가지다. 조사 대상으로 삼았다는 기록만으로 침입 성공을 계산할 수는 없다. 피해가 보고된 사례가 있더라도, 그 원인이 앞서 연구한 특정 후보였다는 연결 근거가 없다면 두 사실을 하나의 공격 경로로 합쳐서는 안 된다.
자동화의 효과를 어디까지 말할 수 있을까
Anthropic은 AI의 효과를 속도·규모·깊이로 설명하면서, 사람의 주요 판단은 남아 있고 자율성과 피해 심각도는 별개라고 명시한다.3
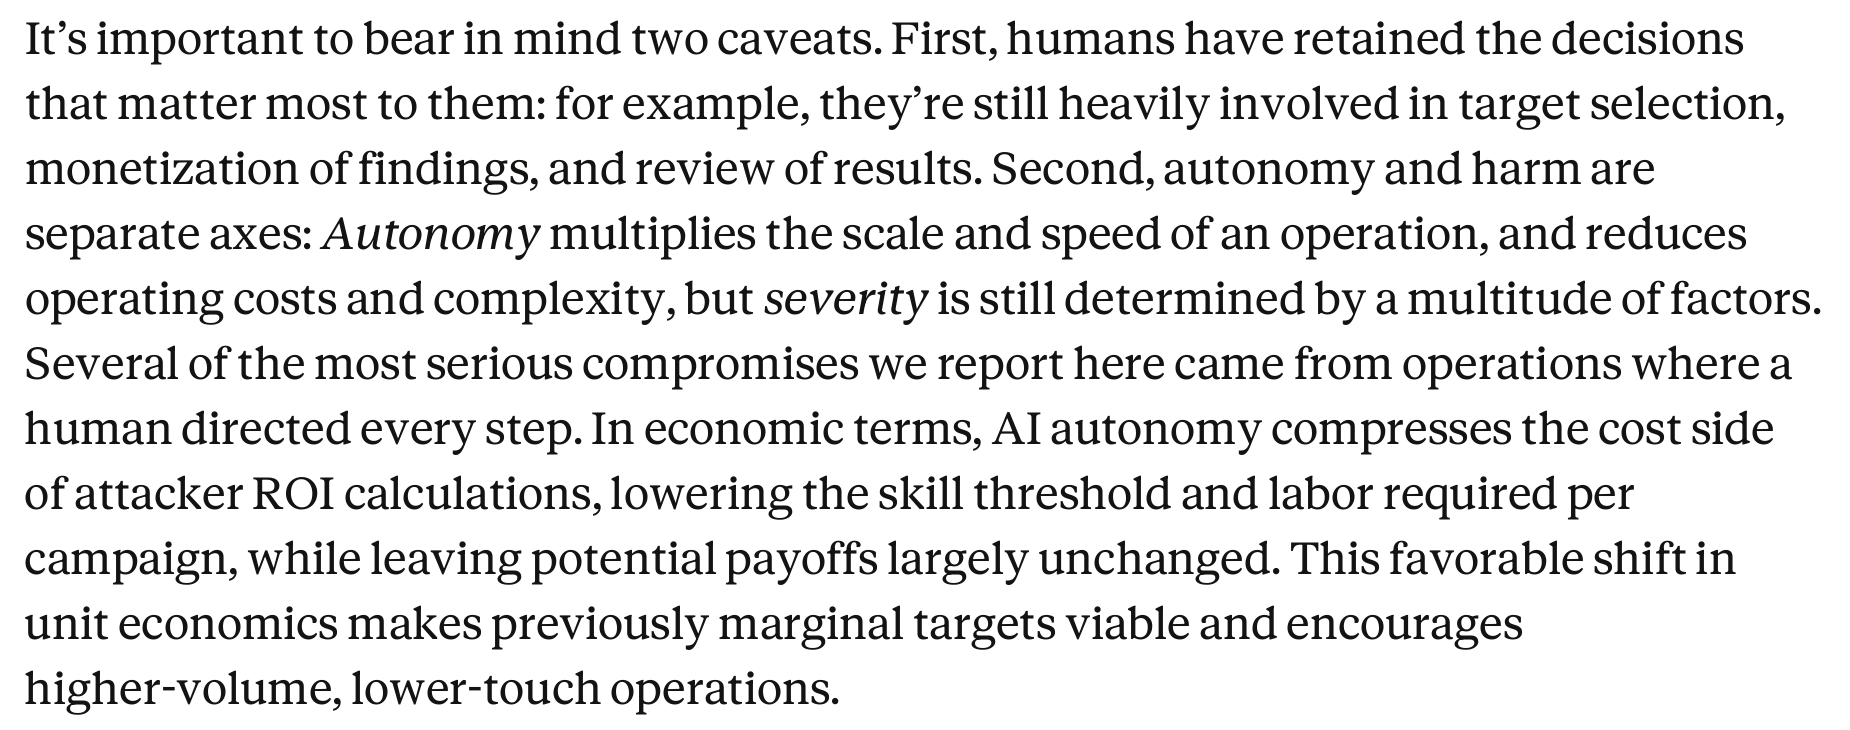
출처: Anthropic 보고서, 39쪽.
이 보고서는 결론적으로 공격 작업 사이를 연결하고 유지하는 데 필요한 수고가 줄어들 수 있다는 내용을 보여준다. 어떤 작업의 결과를 읽고, 다음 작업에 필요한 정보만 전달하고, 중단 지점을 기록하는 일도 운영 비용에 포함되기 때문이다.
다만 이 설명을 특정한 비용 절감률이나 성공률로 바꾸지는 않았다. 같은 대상에 대해 사람이 직접 수행한 경우와 에이전트를 사용한 경우를 동일한 조건으로 비교한 실험이 필요하다. 작업 시간뿐 아니라 모델 사용량, 실패한 시도, 사람의 수정 시간도 함께 세어야 한다.
여러 에이전트의 작업 분담은 정상적인 서비스에서도 쓰인다. Anthropic이 별도로 공개한 Research 시스템도 총괄 에이전트가 여러 하위 에이전트에게 조사를 맡긴다. 해당 문서는 병렬 처리의 이점과 함께 장시간 실행 중 오류가 누적되는 문제, 토큰 사용량과 작업을 조율하는 데 드는 비용을 다룬다.5 이는 GTG-10007의 내부 구현을 설명하는 근거가 아니라, 여러 에이전트를 운영할 때 생기는 일반적인 설계 문제를 비교할 자료다. 작업 수가 늘어난 만큼 비용이 줄어드는지는 실제 운영 조건에서 따져야 한다.
방어 관점에서는 어떤 기록이 필요한가
앞선 작업 방식을 보안 운영에 적용해 보면, 외부 공격을 조사하는 입장과 자체 에이전트를 운영하는 입장에서 필요한 기록이 다르게 보인다.
여러 작업이 연결되어 진행된다면, 방어하는 쪽에서도 개별 이벤트를 따로 보는 것만으로는 전체 활동을 파악하기 어렵다. 별개의 요청처럼 보이는 동작들이 같은 계정이나 세션에서 이어졌다면, 어떤 권한으로 시작해 어느 자원까지 접근했는지 연결해서 볼 필요가 있다. 이때 ‘AI가 했다’는 이름표보다 실제 사용된 계정과 접근 경로가 조사에 더 직접적인 정보다.
피해 조직이 공격자 측 모델의 대화나 내부 작업 기록까지 볼 수 있는 것은 아니다. 반면 자체 로컬 에이전트를 운영한다면 작업 지시와 도구 실행, 결과 판정의 관계까지 남길 수 있다.
이때 누가 어떤 범위의 작업을 에이전트에 허용했는지도 기록해야 한다. 이전 단계에서 얻은 정보와, 그 정보를 이용해 다른 자원에 접근할 권한은 다르다. 새 자원을 발견했다는 이유만으로 접근 범위가 늘어나지 않는지 확인할 필요가 있다.
취약점 진단 툴과 연결
내가 만들고 있는 취약점 진단 툴에서도 이런 기록을 남기고 검토하는 기준을 세워 보려 한다.
공개 보안 공지에 근거한 결과와 아직 검증하지 않은 취약점 후보는 판단의 근거가 다르다. 로컬 테스트에서 동작을 확인했더라도 실제 제품에 미치는 영향까지 입증한 것인지는 따로 살펴야 한다. 이런 차이가 기록과 상태에 드러나야 검토하는 사람이 무엇을 더 확인해야 할지 알 수 있다.
이 툴에 적용할 기준은 어떤 근거로 취약점 후보를 검토 대상으로 남겼는지 설명할 수 있는가다. 모델의 제안과 도구의 실제 출력, 사람의 검토 결론이 연결되어야 한다. 기록에는 어떤 대상과 환경에서 내린 판단인지도 함께 남아야 한다. 이번 보고서와의 비교를 이런 검증 기준을 세우는 데 활용하려 한다.
참고자료
확인일: 2026년 9월 18일.
Footnotes
-
Anthropic, Threat Intelligence. 2026년 9월 보고서 공개일: 2026-09-10. ↩
-
Anthropic, Detecting and countering misuse of AI: September 2026, 도입부와 「AI-augmented cyber operations」 절. ↩ ↩2
-
같은 보고서의 「AI’s increasingly autonomous role in cyber operations」 절. ↩ ↩2
-
같은 보고서의 「GTG-10007: Exploit foundries and autonomous attack frameworks」 절. 서술은 Anthropic의 조사 결과이며 이 글에서 독립 검증한 피해 사실이 아니다. ↩ ↩2 ↩3 ↩4
-
Anthropic, How we built our multi-agent research system, 2025-06-13. 정상적인 Research 시스템의 설계 설명이며 GTG-10007의 내부 구현 근거로 사용하지 않았다. ↩